KI On-Premise, EU-Cloud oder Hyperscaler: Wie viel Souveränität Ihre Daten wirklich brauchen
 Markus C. Weiss, BScCTO, RECOVeröffentlicht am 8 Min.
Am 10. Juni 2025 saß der Rechtsdirektor von Microsoft Frankreich vor einem Untersuchungsausschuss des französischen Senats und wurde unter Eid gefragt, ob er garantieren könne, dass Daten französischer Bürger nie ohne Zustimmung Frankreichs an US-Behörden gehen. Er sagte, das könne er nicht garantieren. Vorgekommen sei es bisher allerdings nie.
Wer das liest, fragt sich schnell, ob die eigene KI jetzt On-Premise laufen muss. Meine Antwort als CTO lautet für die meisten Unternehmen mit 50–500 Mitarbeitenden Nein. KI On-Premise lohnt sich für eine oder zwei Datenklassen, selten für alles. Wer jede Anfrage im eigenen Serverraum verarbeiten will, kauft sich ein Patch-Problem und dauerhaft Personalzeit für den Betrieb, die in keiner Hardware-Rechnung auftaucht. Geschützt werden damit dann auch Website-Texte, die ohnehin veröffentlicht werden.
Widerspruch kommt aus zwei Richtungen. Die einen halten die EU-Region des Hyperscalers samt Data Privacy Framework für ausreichend. Die anderen halten nur den eigenen Server für souverän. Beide verwechseln den Standort eines Rechenzentrums mit der Kontrolle über die Daten.
Dieser Beitrag ist eine technische Einordnung aus unserem Branchenverständnis, Stand Oktober 2026, und keine Rechtsberatung.
Was der CLOUD Act tatsächlich regelt
Der CLOUD Act vom März 2018 hat einen kurzen Paragraphen ins US-Recht eingefügt, 18 U.S.C. § 2713. Anbieter von Kommunikations- und Cloud-Diensten müssen Daten herausgeben, die in ihrem Besitz, ihrer Obhut oder unter ihrer Kontrolle sind, egal ob diese Daten in den USA oder anderswo liegen. Das tragende Wort ist Kontrolle. Ein Rechenzentrum in Frankfurt ändert daran nichts, solange ein US-Konzern den Betrieb kontrolliert.
Daneben steht Section 702 des FISA, die Überwachung von Nicht-US-Personen außerhalb der USA über US-Anbieter erlaubt. Die gesetzliche Ermächtigung ist im Juni 2026 ausgelaufen, weil sich der Kongress nicht auf eine Verlängerung einigen konnte. Laut Brennan Center läuft die Überwachung auf Basis der bestehenden Zertifizierungen trotzdem bis März 2027 weiter. Was danach gilt, ist offen.
Für die Übermittlung personenbezogener Daten in die USA gilt seit Juli 2023 das EU-US Data Privacy Framework. Das Gericht der EU hat die Klage des französischen Abgeordneten Philippe Latombe am 3. September 2025 abgewiesen (T-553/23). Latombe hat Rechtsmittel eingelegt, das Verfahren C-703/25 P liegt beim Gerichtshof. Die beiden Vorgänger, Safe Harbor und Privacy Shield, hat der Gerichtshof 2015 und 2020 gekippt. Ich würde keine Architektur bauen, die nur hält, solange das dritte Abkommen hält.
Diese Einordnung zum Data Privacy Framework gibt unser Branchenverständnis mit Stand Oktober 2026 wieder und ist keine Rechtsberatung. Ob eine Übermittlung in die USA im Einzelfall zulässig ist, klären Sie bitte mit Ihrer Datenschutzberatung.
Zur Fairness gehört der zweite Teil der Aussage im Senat. Laut Microsoft hat in den drei Jahren davor keine solche Anfrage ein europäisches Unternehmen betroffen. Der Ausschussvorsitzende merkte an, dass die zugrunde liegenden Transparenzberichte niemand extern prüft. Das Risiko ist also real, aber klein. Klein heißt nicht null. Für einen Newsletter-Entwurf spielt es keine Rolle, für ein Protokoll aus einem Personalgespräch schon.
Vier Optionen und wogegen sie jeweils schützen
Die EU-Region eines US-Hyperscalers, also ein KI-Dienst von Microsoft, Google oder AWS aus einem europäischen Rechenzentrum, erfüllt Vorgaben zur Datenresidenz und hält die Latenz niedrig. Gegen § 2713 schützt sie nicht. Dafür bekommen Sie die stärksten proprietären Modelle, Sicherheitsupdates ohne eigenes Zutun und Zertifizierungen, die sich ein KMU allein nie leisten würde.
EU-souveräne Clouds gibt es in zwei Bauarten. Europäische Anbieter ohne US-Mutter hosten Open-Weight-Modelle oder eigene Modelle, die US-Konzerne bauen eigene Konstruktionen. AWS hat im Jänner 2026 seine European Sovereign Cloud in Brandenburg gestartet, mit einer neuen europäischen Muttergesellschaft, drei deutschen GmbHs und einem Betrieb ausschließlich durch Personal mit Wohnsitz in der EU. Ob ein US-Gericht so eine Struktur als außerhalb der Konzernkontrolle ansieht, ist meines Wissens nie getestet worden. Bei einem Anbieter ohne Gesellschaft in den USA stellt sich die Frage erst gar nicht.
Ein dedizierter Server bei einem europäischen Hoster, auf dem Sie selbst ein Open-Weight-Modell betreiben, holt die Kontrolle zu Ihnen. Root-Zugang, Modellversion und Löschung liegen bei Ihnen, der Hoster stellt Strom, Netz und Hardware.
On-Premise heißt, die Hardware steht in Ihrem Haus. Nur diese Variante läuft auch ohne Internetverbindung, und nur hier hat niemand außer Ihnen physischen Zugriff. Gleichzeitig ist jede Lücke im Betriebssystem, im GPU-Treiber und im Inferenz-Server Ihr Problem, am Freitagabend genauso wie im Urlaub der einen Person, die das System versteht. Souveränität ist hier vor allem Arbeit.
Ein technisches Detail geht in Verkaufsgesprächen gern unter. Kundenverwaltete Schlüssel schützen Daten beim Speichern. Während der Verarbeitung muss das Modell den Klartext sehen, und das passiert auf der Hardware dessen, der den Dienst betreibt.
Welche Datenklasse welche Option rechtfertigt
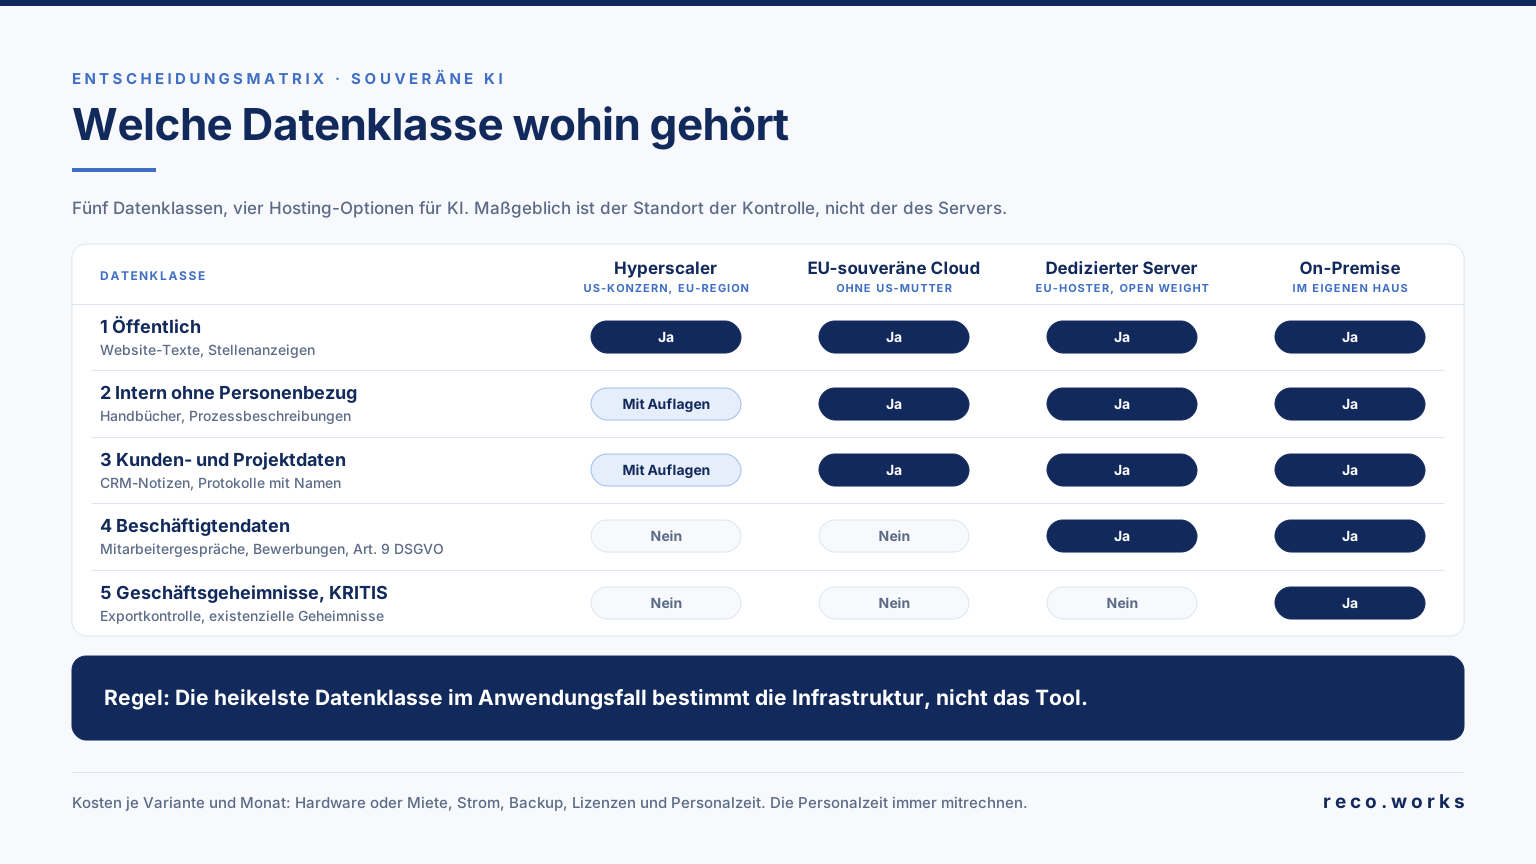
Ich entscheide deshalb nicht pro Tool. Ich entscheide pro Datenklasse, und für die meisten Unternehmen reichen fünf. Die folgende Zuordnung ist meine Arbeitsregel.
- Öffentliche oder zur Veröffentlichung bestimmte Inhalte wie Website-Texte und Stellenanzeigen dürfen in jede der vier Optionen, am günstigsten meist in die Hyperscaler-Region.
- Interne Inhalte ohne Personenbezug, etwa Handbücher und Prozessbeschreibungen, gehören in die Hyperscaler-Region mit Auftragsverarbeitungsvertrag und vertraglich ausgeschlossenem Training, besser noch in eine EU-souveräne Cloud.
- Personenbezogene Kunden- und Projektdaten, etwa CRM-Notizen und Besprechungsprotokolle mit Namen, gehören in eine EU-souveräne Cloud oder auf einen dedizierten Server, in die Hyperscaler-Region nur mit Standardvertragsklauseln und dokumentierter Risikoabwägung.
- Beschäftigtendaten und besondere Kategorien nach Art. 9 DSGVO, also Mitarbeitergespräche, Bewerbungen und Gesundheitsangaben, gehören auf einen dedizierten Server bei einem EU-Anbieter oder On-Premise.
- Geschäftsgeheimnisse, an denen das Unternehmen hängt, sowie Daten mit Exportkontrolle oder aus kritischer Infrastruktur gehören On-Premise, im Zweifel ohne Verbindung nach außen.
Prüfen Sie das an Ihren eigenen Daten. Bitten Sie drei Personen aus verschiedenen Abteilungen, ihre letzten zehn KI-Anfragen je einer Klasse zuzuordnen. Jede Anfrage, die in Klasse vier oder fünf landet, zeigt auf einen Anwendungsfall, der eine eigene Umgebung braucht. Für den Rest brauchen Sie sie nicht.
Meetings sind der Ort, an dem die heiklen Klassen am leichtesten entstehen, weil im selben Gespräch über ein Angebot und über die Krankmeldung eines Kollegen geredet wird. Was das für KI-Notetaker heißt, steht im Beitrag zu KI-Notetakern und DSGVO, die arbeitsrechtliche Seite im Beitrag zum Dokumentieren von Mitarbeitergesprächen. Wir haben die Abwägung für RECO selbst treffen müssen, und weil es unser Produkt ist, lesen Sie den Satz bitte mit Skepsis. Gesprächsdokumentation fällt in der Regel in Klasse drei oder vier, deshalb verarbeiten wir auf EU-Servern mit einem dedizierten Server in Deutschland und bieten für Klasse fünf eine On-Premise-Variante an.
Was KI On-Premise im Betrieb wirklich kostet
Die Rechnungen im Netz vergleichen meist Hardware mit API-Preisen. Der Posten, der dabei fehlt, ist die Personalzeit. Ich gebe Ihnen hier bewusst keine Beispielpreise, die in einem Jahr ohnehin überholt wären, sondern das Schema, nach dem ich rechnen würde. Die Eingaben kommen aus Ihren Angeboten und aus Ihrer Lohnverrechnung.
Am Anfang steht die Modellgröße, denn sie bestimmt die Hardware. Der Grafikspeicher für die Gewichte ergibt sich aus Parameterzahl mal Bytes pro Parameter. Bei 4-Bit-Quantisierung ist das ein halbes Byte, ein Modell der 70-Milliarden-Parameter-Klasse braucht also rund 35 GB allein für die Gewichte. Dazu kommt Reserve für den Kontext jeder gleichzeitigen Anfrage. Erst mit dieser Zahl können Sie GPU-Angebote sinnvoll vergleichen.
Danach addieren Sie pro Variante und Monat diese Posten:
- Hardware: Kaufpreis laut Angebot, geteilt durch die Monate der Abschreibung, beim gemieteten Server die Monatsmiete.
- Strom und Kühlung: durchschnittliche Leistungsaufnahme in kW mal Betriebsstunden im Monat mal Ihr Preis je kWh. Den Durchschnitt messen Sie im Testbetrieb, das Datenblatt nennt die Höchstlast.
- Backup, Monitoring und Ersatzteile laut Angebot Ihres Dienstleisters.
- Personalzeit: der Stellenanteil für Treiber, Inferenz-Server, Modell-Updates, Berechtigungen und die Reaktion auf kritische Lücken am selben Tag, mal die jährlichen Arbeitgeberkosten dieser Stelle, geteilt durch zwölf.
- Beim Hyperscaler: Lizenzpreis je Nutzer laut aktueller Preisliste mal Zahl der Nutzer, plus die Administrationszeit.
Beim gemieteten Server fällt die Hardwarepflege weg, die Softwarepflege nicht. Setzen Sie den Personalanteil dort niedriger an als bei On-Premise, aber nie mit null. Die Hardware kaufen Sie einmal und schreiben sie ab, die Personalzeit fällt jeden Monat an, solange das System läuft. Deshalb kann sie die ganze Rechnung drehen.
Ein Stellenanteil ist außerdem kein Mensch. Fällt die eine Person aus, steht Ihre KI für Klasse vier still, bis jemand eingearbeitet ist. Wer On-Premise braucht, sollte deshalb einen Wartungsvertrag mit einem Dienstleister und eine Zweitbesetzung haben, bevor das erste Modell produktiv läuft.
Bei der Qualität reichen Open-Weight-Modelle dieser Größe nach meiner Einschätzung für Zusammenfassen, Klassifizieren und das Durchsuchen eigener Dokumente. Bei langen, mehrstufigen Schlussfolgerungen liegen die großen proprietären Modelle vorne.
Der Ausstieg wird meist vergessen
Souveränität heißt für mich auch, gehen zu können. Zur Wissenssicherung gehört deshalb, dass dokumentierte Entscheidungen und ihre Quellen bei einem Anbieterwechsel vollständig und weiter nutzbar im Unternehmen bleiben. Fragen Sie vor jedem Vertrag, ob Sie Daten, Prompt-Vorlagen und Suchindizes in einem offenen Format zurückbekommen. Fragen Sie, ob das Modell, mit dem Ihre Abläufe heute funktionieren, über die Vertragslaufzeit hinaus noch angeboten wird. Proprietäre Modellversionen werden abgekündigt, die Gewichte eines Open-Weight-Modells liegen dagegen bei Ihnen.
Open-Weight bedeutet allerdings nicht automatisch Open Source. Die Llama-Modelle von Meta stehen unter einer eigenen Lizenz mit Bedingungen, einige Mistral-Modelle unter Apache 2.0. Die Lizenz gehört gelesen, bevor ein Modell in einen Kundenprozess wandert. Den allgemeinen Daten-Check für neue Werkzeuge habe ich im Beitrag zu den KI-Tools für das zweite Halbjahr 2026 beschrieben. Wer Agenten auf eigene Systeme loslassen will, sollte die Hosting-Frage vor dem Pilot klären. Warum, steht im Beitrag zu KI-Agenten im Mittelstand.
Womit ich anfangen würde
Mit einer Liste, nicht mit einem Hardware-Angebot. Eine Zeile pro KI-Anwendungsfall, daneben die höchste Datenklasse, die darin vorkommt. Für die meisten Unternehmen dieser Größe erwarte ich zwei Säulen, ein breit genutzter Cloud-Dienst für die Klassen eins und zwei und eine kleine, kontrollierte Umgebung für Personal- und Gesprächsdaten. Ein eigener Server für alles ist dabei so selten die richtige Antwort wie zehn Tools ohne jede Klassifizierung.
Quellen
- 18 U.S.C. § 2713, eingefügt durch den CLOUD Act (Pub. L. 115-141, 23. März 2018), Cornell LII
- Sénat, Untersuchungsausschuss Commande publique, Anhörung Microsoft vom 10. Juni 2025 (Protokoll)
- Rechtsmittel Latombe/Kommission, Rs. C-703/25 P, Amtsblatt der EU C/2025/6610
- WilmerHale: European Court of Justice to Review Challenge to EU-U.S. Data Privacy Framework (1. Dezember 2025)
- Brennan Center for Justice: Section 702 of FISA, 2026 Resource Page
- EFF: Victory! 702 has Expired! (12. Juni 2026)
- Amazon: AWS launches AWS European Sovereign Cloud (Pressemitteilung, Jänner 2026)
Häufige Fragen zu diesem Thema
Ist Microsoft Copilot mit EU-Datengrenze DSGVO-konform nutzbar?+
Für viele Anwendungsfälle ja, wenn ein Auftragsverarbeitungsvertrag besteht, die Übermittlung über das Data Privacy Framework oder Standardvertragsklauseln abgesichert ist und Sie die Nutzung dokumentiert haben. Die EU-Datengrenze regelt, wo Daten gespeichert und verarbeitet werden. An der Kontrolle durch einen US-Konzern und damit an § 2713 ändert sie nichts. Für die Datenklassen eins bis drei halte ich das für vertretbar. Für Beschäftigtendaten würde ich eine Datenschutz-Folgenabschätzung machen und eher eine andere Umgebung wählen. Keine Rechtsberatung.
Welche Hardware brauche ich, um ein LLM selbst zu hosten?+
Als Faustregel rechnen Sie Parameterzahl mal Bytes pro Parameter. Ein Modell mit 8 Milliarden Parametern braucht bei 4-Bit-Quantisierung rund 4 GB für die Gewichte, eines mit 70 Milliarden rund 35 GB. Dazu kommt Speicher für den Kontext jeder laufenden Anfrage, und der wächst mit langen Dokumenten und vielen gleichzeitigen Nutzern schnell. Mieten Sie vor dem Kauf einen GPU-Server für eine Testphase und messen Sie mit Ihren echten Dokumenten, ab wie vielen parallelen Anfragen die Antwortzeit spürbar steigt.
Fällt ein europäischer Cloud-Anbieter mit US-Tochter unter den CLOUD Act?+
§ 2713 richtet sich an Anbieter, die US-Recht unterliegen, und an Daten unter deren Kontrolle. Nach meinem Verständnis kommt es darauf an, ob die US-Gesellschaft tatsächlich Zugriff auf Ihre Daten hat oder ihn rechtlich durchsetzen kann, und das ist juristisch nicht abschließend geklärt. Ausschlaggebend sind Konzernstruktur und Administrationsrechte, der Standort des Rechenzentrums spielt dafür keine Rolle. Lassen Sie sich vom Anbieter schriftlich bestätigen, welche Gesellschaften Administratorzugriff haben und ob es eine Niederlassung in den USA gibt. Keine Rechtsberatung.
Ähnliche Artikel
In einer 30-minütigen Software Demo zeigen wir Ihnen, wie RECO Wissen in Ihrem Unternehmen sichert und weitergibt. Jetzt Demo anfragen, wir melden uns mit einem Terminvorschlag.